Какой компьютер Acer нужен для локальных нейросетей: память, GPU, NPU и совместимость ПО?
Для локальной нейросети сначала проверяют совместимость программы и объём памяти, затем скорость. Название AI PC, число TOPS или наличие NPU не гарантируют запуск выбранной модели. Нужно знать архитектуру компьютера, доступный вычислительный backend, формат весов, длину контекста и количество одновременных пользователей.
Разберём подбор Acer для локального помощника, работы с документами, генерации и экспериментов с моделями. Отдельно сравним обычный ПК с дискретной графикой и системы с общей памятью. Главная цель — получить воспроизводимую конфигурацию под конкретное ПО, а не купить максимальное рекламное число.
Какой компьютер нужен для локальной нейросети?
В заявке должны быть три ответа: какую модель запускаем, в какой программе и что считаем приемлемой работой. Для личного помощника важны задержка первого ответа и скорость генерации, для обработки пакета документов — время всего задания, для нескольких сотрудников — устойчивость очереди и одновременных запросов.
Инференс, адаптация и обучение с нуля — разные нагрузки. Компьютер, подходящий для запуска готовой квантованной модели, может не иметь достаточно памяти для её полного обучения. Не переносите требования одной задачи на другую только из-за одинакового числа параметров.
| Задача | Что нужно определить до покупки | Как измерять результат |
|---|---|---|
| Личный локальный чат | Модель, контекст, backend | Первую задержку и скорость ответа |
| Поиск и ответы по документам | Индексацию, embeddings, базу и генерацию | Время индексации и качество ответов |
| Несколько пользователей | Одновременность и правила очереди | Задержки под общей нагрузкой |
| Генерация изображений | Модель, разрешение, режимы и дополнения | Время задания и пиковую память |
| Адаптация модели | Метод, разрядность, оптимизатор | Память и время шага |
| Обучение с нуля | Полный масштаб задачи и данные | Распределённую инфраструктуру и бюджет |
Если пока нет выбранного ПО, начинайте с пилота на доступной машине или проверенной тестовой системе. Результат пилота должен дать требования для закупки. Покупка оборудования до выбора программного стека часто приводит к несовместимости, которую нельзя устранить дополнительной RAM.
Как рассчитать память по числу параметров модели?
Первое приближение для весов: число параметров × битность ÷ 8. Для 8 млрд параметров при 16 битах это около 16 ГБ, при 8 битах — 8 ГБ, при 4 битах — 4 ГБ в десятичном подсчёте. Это только арифметический объём весов, не полный расход памяти процесса.
| Размер модели | Веса при 16 битах, примерно | При 8 битах | При 4 битах |
|---|---|---|---|
| 8 млрд параметров | 16 ГБ | 8 ГБ | 4 ГБ |
| 14 млрд | 28 ГБ | 14 ГБ | 7 ГБ |
| 32 млрд | 64 ГБ | 32 ГБ | 16 ГБ |
| 70 млрд | 140 ГБ | 70 ГБ | 35 ГБ |
Реальный квантованный файл включает масштабы, метаданные и другие данные. Во время работы добавляются KV-кэш, промежуточные буферы, память runtime и операционной системы. Поэтому модель с расчётными весами 16 ГБ нельзя автоматически считать подходящей для GPU с 16 ГБ VRAM.
Для некоторых архитектур активных параметров за один шаг меньше общего числа. Но для хранения часто нужны все веса или особая схема загрузки, поэтому число «активных» параметров не всегда описывает потребность памяти. Смотрите конкретный формат и реализацию, затем подтверждайте измерением.
Почему длинный контекст требует больше памяти?
При авторегрессионной генерации сохраняется информация для внимания, обычно в KV-кэше. Его размер зависит от архитектуры, числа слоёв, голов, типа данных, длины контекста и количества последовательностей. При прочих равных увеличение контекста и параллельности увеличивает этот расход.
Нет универсального правила «каждые 1000 токенов занимают столько-то гигабайт» для всех моделей. Для закупки проверьте короткий запрос, длинный документ и несколько одновременных запросов. Максимальный контекст в настройках программы также может резервировать ресурсы, которые при коротком чате остаются незаметными.
VRAM, RAM и общая память: в чём разница?
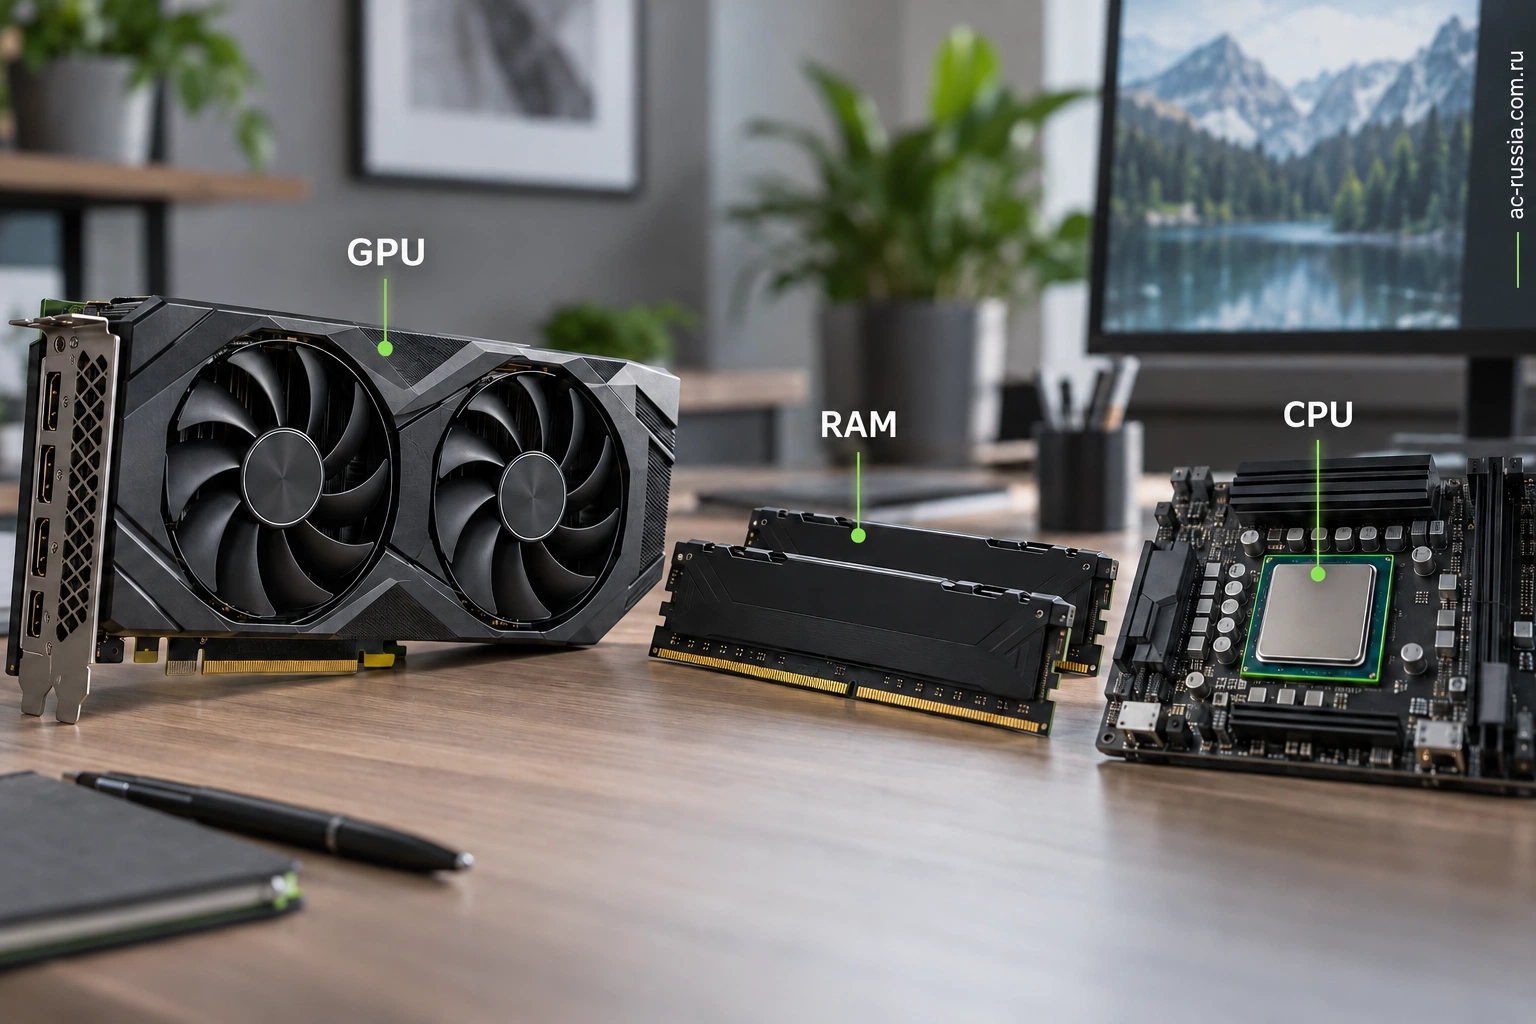
У обычного ПК системная RAM и память дискретной видеокарты — разные области. Например, 64 ГБ RAM и 12 ГБ VRAM не превращаются автоматически в единые 76 ГБ быстрой памяти GPU. Частичное выполнение на CPU или выгрузка отдельных слоёв возможны в некоторых программах, но меняют скорость и схему работы.
В платформе с общей памятью CPU и GPU могут использовать общий физический пул по правилам архитектуры и драйвера. Это облегчает некоторые сценарии размещения больших моделей, но не делает весь объём свободным: систему, приложения и служебные данные тоже нужно разместить. Пропускная способность и вычислительные возможности остаются самостоятельными ограничениями.
| Конфигурация | Что даёт | Что проверить |
|---|---|---|
| CPU и обычная RAM | Широкий выбор программ и гибкая ёмкость | Скорость генерации на CPU |
| Дискретный GPU | Поддерживаемое ускорение и отдельную VRAM | Backend, память и конкретную модель |
| Общая память CPU/GPU | Возможность общего размещения данных | Реальный доступный объём и скорость |
| Несколько GPU | Дополнительные ресурсы при поддержке ПО | Распределение модели и межсоединение |
| NPU | Специализированное ускорение поддерживаемых задач | Runtime, форматы и поддержку операций |
Как собрать полный бюджет памяти модели и контекста?
Первоначальный расчёт весов — только начало. Для рабочего запуска нужны веса, KV-кэш, временные буферы, память исполнительной среды и ресурсы системы. В общей памяти платформы эти части конкурируют за один физический бюджет. В системе с дискретной GPU часть расходов приходится на VRAM, часть на системную RAM. Две системы с одинаковой общей суммой гигабайт поэтому нельзя считать эквивалентными автоматически.
Не смешивайте десятичные гигабайты и двоичные гибибайты. 1 ГБ — 1 000 000 000 байт, 1 ГиБ — 1 073 741 824 байта. Арифметические веса 8 млрд параметров по 4 бита занимают 4 млрд байт, или примерно 3,73 ГиБ. Реальный квантованный файл имеет дополнительные данные. Если программа показывает память в GiB, сравнивайте значения в одинаковых единицах.
Пример расчёта KV-кэша
Для обычного случая полного хранения ключей и значений можно использовать приближение: 2 × число слоёв × число KV-голов × размер головы × число токенов × байт на элемент × число независимых последовательностей. Двойка соответствует ключам и значениям. Формула не описывает все архитектуры и стратегии: скользящее внимание, квантизация кэша, разделение префиксов и реализация runtime могут менять расход.
Возьмём условную архитектуру: 32 слоя, 8 KV-голов, размер головы 128, элементы по 2 байта. При контексте 8192 токена и одной последовательности получится 2 × 32 × 8 × 128 × 8192 × 2 = 1 073 741 824 байта, то есть 1 ГиБ. При 32 768 токенах — 4 ГиБ. При четырёх независимых последовательностях той же длины — 16 ГиБ до дополнительных расходов. Это учебная архитектура, а не измерение конкретной модели.
| Условный контекст | Независимых последовательностей | Расчётный KV-кэш в данном примере |
|---|---|---|
| 8192 токена | 1 | 1 ГиБ |
| 16 384 токена | 1 | 2 ГиБ |
| 32 768 токенов | 1 | 4 ГиБ |
| 32 768 токенов | 4 | 16 ГиБ |
Длина контекста включает нужную модели историю и данные текущего запроса. Для оценки учитывают также генерируемое продолжение в пределах выбранного режима. Считать только текст пользователя недостаточно: системная инструкция, найденные документы и история диалога добавляют токены. Количество слов не переводится в токены одним универсальным коэффициентом, особенно для разных языков и токенизаторов.
Почему короткий запрос иногда резервирует много памяти?
Исполнительная среда может заранее резервировать ресурсы под максимальный размер или выбранный тип кэша. Поэтому короткий тест с высоким лимитом контекста способен занимать больше памяти, чем ожидает пользователь. Динамический и статический кэш имеют разные компромиссы; менять стратегию нужно с учётом модели и программы. В протоколе фиксируйте и фактический запрос, и настроенный лимит.
Резерв памяти не следует выбирать только по универсальным «плюс 10%». Проверьте реальный пик на задачах, затем определите запас под будущий контекст, пользователей и обновления. Если веса почти заполняют VRAM, даже скромное продолжение может оказаться проблемой. Если модель частично переносится на CPU, она может работать, но с другим временем ответа. Сам факт запуска не подтверждает нужную производительность.
Почему NPU и TOPS не показывают скорость любой нейросети?
NPU предназначен для поддерживаемых операций и программных путей. Если ваша программа использует CUDA, наличие NPU не включает его автоматически. Если runtime поддерживает NPU, всё равно нужно проверить формат модели, доступные операции и ограничения памяти.
TOPS обычно относится к определённой точности и условиям выполнения. Числа INT8, FP16 и FP4 нельзя сопоставлять без контекста. Теоретическая вычислительная мощность не превращается прямо в токены в секунду: влияют память, архитектура модели, размер запроса и программная реализация.
Для выбора сравнивайте одинаковую модель, одинаковую квантизацию, контекст и настройки. Отдельно измеряйте обработку входного текста и генерацию ответа: эти этапы могут по-разному нагружать оборудование. Один короткий тест не описывает поведение системы при длинных документах.
Veriton GN100 и RI110: почему их нельзя считать одной платформой?
Veriton GN100 — система на NVIDIA GB10 с 20-ядерным Arm CPU и 128 ГБ общей LPDDR5X-памяти. Её программная среда ориентирована на стек NVIDIA и DGX OS. Ёмкость SSD зависит от комплектации; варианты накопителя не меняют архитектуру платформы.
Анонсированная Veriton RI110 построена на Intel Core Ultra X7 358H и Intel Arc B390, с конфигурациями до 96 ГБ LPDDR5X и до 4 ТБ SSD. Это другая архитектура и другой программный путь. Указанные максимумы не означают, что каждый артикул оснащён максимальными памятью и накопителем.
| Платформа | Архитектурный ориентир | Главный вопрос перед выбором |
|---|---|---|
| Veriton GN100 | Arm CPU, NVIDIA GB10, общая память | Есть ли нужное ПО и зависимости для Arm/Linux |
| Veriton RI110 | Intel x86, Intel Arc, общая память платформы | Поддерживает ли runtime нужное ускорение Intel |
| ПК с дискретным GPU | Отдельная системная RAM и VRAM | Помещается ли модель и поддерживается ли backend |
Нельзя считать x86-исполняемый файл автоматически совместимым с Arm. Python-код может быть переносим, но его зависимости, контейнеры, бинарные расширения и драйверы могут требовать отдельной сборки. Аналогично поддержка одной GPU-платформы не гарантирует поддержку другой.
В карточке Veriton GN100 UD11 и карточке Veriton RI110 проверяйте конкретную конфигурацию и условия заказа. Для проекта сначала подтвердите программную совместимость, затем согласуйте поставляемый SKU и сроки. Наличие карточки не заменяет эту проверку.
Как проверить совместимость программы до закупки?
Запишите операционную систему, архитектуру, версию runtime и backend. Затем соберите список зависимостей: модели, токенизатор, библиотека вычислений, контейнер, плагины и интерфейс. Проверьте возможность установки без случайных неподдерживаемых пакетов.
- Запустите выбранную модель в точном формате весов.
- Проверьте короткий и длинный запрос с одинаковыми настройками.
- Измерьте пиковую память и запас для остальных приложений.
- Проверьте embeddings и индекс документов отдельно от генерации.
- Повторите тест с нужным количеством пользователей.
- Проверьте восстановление после перезапуска и обновления.
- Зафиксируйте версии и рабочую конфигурацию для воспроизводимости.
Если программа «запустилась», но часть вычислений ушла на CPU, это может существенно изменить результат. Проверяйте используемые устройства и backend. Ошибка нехватки памяти при длинном контексте также не опровергается успешным запуском короткого чата.
Какие программные зависимости проверить на Veriton GN100 и Intel-платформе?
Совместимость проверяют снизу вверх: архитектура CPU, ОС, драйвер, исполнительная среда, формат модели и приложение. Python-интерфейс не делает все зависимости переносимыми. Бинарное расширение, библиотека или контейнер могут быть собраны под x86 и не подходить Arm. Даже в одной архитектуре версия GPU-стека и реализованные операции способны изменить результат.
Для Veriton GN100 на GB10 нужен проверенный путь Arm/Linux и совместимый стек NVIDIA. Поддержка пакетов имеет конкретные версии; часть инструментов доступна, часть имеет ограничения. Нельзя считать любую старую сборку CUDA-приложения готовой для новой платформы. В пилоте используйте воспроизводимое окружение и сохраните версии зависимостей, чтобы повторить запуск после обновления или восстановления.
Для Intel CPU, GPU и NPU выбирают подходящий backend. OpenVINO поддерживает разные целевые устройства в рамках совместимых моделей и конфигураций, но наличие Intel Arc не означает запуск любого CUDA-проекта без изменений. Формат GGUF тоже не является названием ускорителя: нужна исполнительная среда, которая поддерживает этот формат и аппаратный путь. Для анонсированной RI110 совместимость конкретного ПО подтверждают отдельно для поставляемой конфигурации.
| Уровень проверки | Вопрос перед закупкой |
|---|---|
| CPU | Есть ли сборки и зависимости для Arm или x86 нужной системы? |
| ОС | Поддерживает ли её приложение и корпоративная среда? |
| GPU/NPU | Реализован ли нужный backend и поддерживаются ли операции? |
| Модель | Подходят ли архитектура, формат и квантизация? |
| Контейнер | Совместимы ли образ, архитектура и драйверный стек? |
| Обновление | Можно ли повторно установить и проверить окружение? |
NPU интересен для поддерживаемых задач, но универсальное число TOPS не сообщает скорость выбранной языковой модели. Оно зависит от точности и условий вычисления и не переводится напрямую в токены в секунду. Для закупки запросите результат нужного приложения или проведите собственный пилот. Если задача не использует NPU, его паспортная производительность не уменьшает ожидание автоматически.
Локальная нейросеть и корпоративные документы: что включить в проект?
Локальный запуск может уменьшить передачу данных внешним сервисам, если весь процесс действительно локальный. Но загрузка модели, телеметрия приложения, внешние плагины и облачная индексация требуют отдельной проверки. Само слово «локальный» не описывает сетевое поведение всех компонентов.
Для ответов по документам нужна организация доступа. Индекс не должен давать сотруднику сведения, которые он не может прочитать в исходной системе. Определите обновление базы, удаление старых документов, журналирование и контроль качества ответов. Быстрая генерация не гарантирует достоверность ответа.
Резервируйте исходные документы, настройки, индексы и важные результаты по принятой политике. Модель можно повторно скачать, а внутренние данные и рабочие конфигурации могут быть уникальны. Разделяйте хранение исходных файлов и временных кэшей.
Чем корпоративный поиск по документам отличается от обычного чата?
Для поиска по внутренним материалам одной языковой модели недостаточно. Нужен процесс получения текстов, их подготовки, поиска подходящих фрагментов и формирования ответа. В распространённой схеме RAG найденные фрагменты добавляются в запрос. Это не то же самое, что обучение модели на всех документах компании. Обновление базы поиска и изменение весов модели — разные операции с разными затратами.
В пилот включите PDF с текстом, отсканированные документы, таблицы и материалы со сложной структурой, если они входят в работу. Плохое распознавание или потерянные заголовки могут испортить результат ещё до генерации. Более мощный GPU не восстановит автоматически отсутствующую строку или неверно извлечённую цифру. Поэтому тест качества начинается с подготовки корпуса.
Как рассчитать место под векторы и документы?
Условный индекс из 1 000 000 фрагментов с векторами размерности 768 и элементами float32 требует только на значения векторов 1 000 000 × 768 × 4 = 3 072 000 000 байт, или 3,072 ГБ. Текст, метаданные, структура поискового индекса, исходные файлы и резервные копии в это число не входят. Реальный размер зависит от способа хранения и выбранной технологии. Пример помогает увидеть состав бюджета, а не задаёт обязательную архитектуру проекта.
Не выбирайте размер фрагмента только ради меньшего индекса. Слишком мелкий фрагмент может потерять контекст таблицы, слишком большой — добавлять лишний текст в запрос. Найдите вариант на контрольных вопросах. Для закупки компьютера важен выбранный реальный процесс: сколько документов поступает, как долго строится индекс и как быстро обрабатывается обращение сотрудника.
| Этап решения | Отдельная проверка | Почему нельзя заменить её тестом чата |
|---|---|---|
| Извлечение текста | Корректность цифр, таблиц и заголовков | Ошибка появляется до запуска языковой модели |
| Подготовка фрагментов | Сохранение нужного контекста | Ответ зависит от найденных данных |
| Индексация | Время обновления, память и место | Это самостоятельная нагрузка |
| Поиск | Находит ли система нужный фрагмент | Быстрая генерация не исправляет неверную выдачу |
| Генерация | Ответ, ссылки на внутренние основания, задержка | Нужна проверка качества и времени вместе |
| Обновление | Когда новый документ становится доступным | Старый индекс способен давать устаревший результат |
Согласуйте, как система отвечает при отсутствии данных. Хороший результат не должен заменять неизвестное уверенным предположением. Для компании полезен контрольный набор, где есть вопросы с найденным ответом, неоднозначные вопросы и вопросы без ответа в корпусе. Тогда тест проверяет пригодность процесса, а не только способность модели написать гладкий текст.
Как сравнить скорость двух компьютеров честно?
| Параметр теста | Что зафиксировать |
|---|---|
| Модель | Название, версия и точный файл весов |
| Квантизация | Формат, разрядность и применённые настройки |
| Вход | Одинаковый текст и длина контекста |
| Выход | Одинаковый предел и правила остановки |
| Программа | Версия, backend и параметры запуска |
| Параллельность | Число одновременных последовательностей |
| Измерения | Первая задержка, генерация, пиковая память, ошибки |
| Условия | Питание, фоновые процессы и прогрев |
Для обслуживания нескольких сотрудников полезны не только средние значения, но и задержки худших запросов. Проверьте, что система не начинает активно выгружать данные на диск при росте очереди. Если требуется гарантированный сервис, добавьте мониторинг, резервирование и процедуру обновления ПО.
Как оценить задержку ответа и одновременную работу пользователей?
Для диалога важны время до первого токена и скорость дальнейшей генерации. Длинный входной документ сначала обрабатывается на этапе prefill, после чего начинается последовательная генерация. Система с хорошим результатом на коротком вопросе не обязательно так же быстро начинает ответ по большому документу. Поэтому в закупке эти показатели проверяют отдельно.
Полное время также включает очередь, поиск документов, подготовку запроса и последующую обработку. Значение токенов в секунду не описывает всё ожидание пользователя. Если компьютер отвечает быстро одному человеку, но остальные запросы стоят в очереди, он может не соответствовать сервису отдела. Одновременность — требование к сценарию, а не просто число установленных учётных записей.
| Метрика | Что она показывает | Какое условие сохранить |
|---|---|---|
| Загрузка модели | Время подготовки к первому запуску | Холодный запуск и место хранения |
| Время до первого токена | Ожидание начала ответа | Длину входа, очередь и обработку документов |
| Скорость генерации | Темп продолжения ответа | Модель, формат и длину результата |
| Полное время | Срок получения готового результата | Все этапы пользовательского запроса |
| Пиковая память | Наибольший расход в цикле | Контекст и одновременные запросы |
| Ошибки и качество | Пригодность ответа для задачи | Контрольный набор и критерии |
Для пилота задайте три уровня: один короткий запрос, один длинный документ и несколько одновременных обращений. Повторите их после прогрева и отдельно при холодном запуске, если программа часто выгружает модель. Сохраняйте индивидуальные результаты, а не только среднее. Отдельные длинные задержки могут быть важнее хорошего среднего для пользователей, которым нужно быстро продолжить работу.
Пример расчёта: если ответ содержит 400 новых токенов, а после первого токена генерация идёт в среднем 20 токенов/с, эта часть занимает около 20 секунд. При ожидании первого токена 8 секунд полный результат получится примерно за 28 секунд без других этапов. Это условный пример, не скорость Acer. Он показывает, почему заявленную скорость генерации нельзя считать полным временем ответа.
При сравнении двух конфигураций используйте одинаковую модель, квантизацию, контекст и задания. Если на одном устройстве запущена меньшая модель или более жёсткая квантизация, результат уже включает изменение качества, а не только аппаратное преимущество. Сначала договоритесь о допустимом качестве ответа, затем сравнивайте время.
Как измерять качество и не выбирать компьютер по красивой демонстрации?
Подготовьте задания, которые сотрудники действительно выполняют: найти условие договора, сравнить версии документа, составить краткое содержание, извлечь числа с сохранением единиц. Для каждого задания задайте критерий правильности. Проверяющий должен видеть исходные данные и готовый ответ. Общая оценка «выглядит умно» недостаточна для закупки рабочего инструмента.
Условный пример методики: из 15 контрольных вопросов на 12 получен полностью пригодный ответ. Доля составляет 12 / 15 = 80%. Это не результат модели или Acer; это способ подсчёта. Для реального вывода маленького набора недостаточно, если задачи разнообразны. Сохраняйте ошибки по типам: неверное число, пропущенное условие, неподтверждённый вывод, не найденный документ. Процент без этих деталей скрывает причину.
Квантизация тоже входит в проверку качества. Более компактный вариант может позволить больший контекст или больше пользователей, но изменение представления требует оценки результата на задачах. Не сравнивайте скорость одного формата с качеством другого и не объявляйте их одинаковыми по названию модели. Для решения нужны совместимые показатели: качество, задержка и расход памяти в одном окружении.
Сохраните версию модели, токенизатор, формат, настройки генерации и контрольный набор. После обновления runtime или модели повторите проверку. Без такого набора улучшение скорости может остаться незаметным, а ухудшение качества — попасть к пользователям. Компьютер Acer должен выполнять воспроизводимую задачу, а не зависеть от единственного удачного запуска.
Какие расходы и обязанности входят в локальное AI-решение?
Помимо компьютера нужны установка, подготовка моделей, интеграция, хранение, резервирование и поддержка. Если инструмент используют несколько сотрудников, потребуется организация доступа и согласованный режим работы. Локальное исполнение не отключает автоматически все внешние соединения приложения: облачные функции, обновления или выбранные модели могут использовать сеть. Проверьте фактическую конфигурацию, а не делайте вывод по слову «локальный».
Для проекта определите владельца обновлений и контрольной базы. Когда модель или документы меняются, кто повторяет тест? Кто восстанавливает среду после отказа? Где находятся настройки и резерв? Эти вопросы влияют на готовность сервиса и стоимость владения. Их полезно решить до закупки, пока можно сравнить несколько схем организации.
Разделите индивидуальную станцию разработчика и общий сервис отдела. Первая может работать по графику одного пользователя, вторая требует одновременности и доступности. Нельзя считать 128 ГБ общей памяти автоматическим доказательством пригодности для любого числа сотрудников. Количество активных запросов, длина документов и требуемое время ответа задают проверяемую нагрузку.
| Требование в заявке | Пример точной формулировки |
|---|---|
| Модель | Название, версия и выбранный формат |
| Задача | Поиск по согласованному корпусу или конкретный тип обработки |
| Контекст | Нужная длина и типовой объём входных материалов |
| Пользователи | Число одновременно активных запросов |
| Время | Допустимое начало и завершение ответа на контрольном наборе |
| Качество | Критерии ответа и порядок проверки |
| Восстановление | Сохранённое окружение, данные и ответственный |
Для анонсированных систем сначала подтвердите сроки и конкретную комплектацию, затем возможность пилота. Карточка будущей модели не является испытанием программного стека. Если образца ещё нет, можно подготовить ТЗ и проверить зависимости, но нельзя обещать измеренную скорость. Для доступного Acer порядок тот же: совместимость, контрольная задача, реальные показатели и согласованный состав поставки.
Можно ли на том же компьютере дообучать модель?
Генерация ответа и обучение — разные нагрузки. При обучении добавляются градиенты, состояние оптимизатора и промежуточные данные для обратного прохода. Их объём зависит от метода, точности, длины последовательностей и batch size. Поэтому факт, что модель помещается для инференса, не подтверждает её обучение в той же памяти.
Полное дообучение меняет большой набор параметров. Методы вроде LoRA работают с дополнительными низкоранговыми параметрами и могут уменьшать объём обучаемой части. Но базовая модель, вычисления и другие расходы остаются. Нельзя объявить любую конфигурацию LoRA одинаково лёгкой или считать успешную генерацию доказательством готового тренировочного процесса.
| Задача | Что меняется | Какой пилот требуется |
|---|---|---|
| Инференс | Используются подготовленные веса | Ответы с нужным контекстом и параллельностью |
| RAG | Поиск добавляет данные в запрос | Подготовка корпуса, поиск и ответы |
| Дообучение адаптера | Обучаются выбранные дополнительные параметры | Реальный метод, данные и полный цикл |
| Полное дообучение | Меняются веса по выбранной схеме | Память, время, сохранение и проверка качества |
Если задача компании — отвечать по обновляемым документам, сначала разберите процесс поиска и подготовки данных. Загрузка документов в запрос не обучает веса автоматически. Если требуется изменение поведения на примерах, нужна отдельная оценка дообучения и контроль качества. Покупка мощного Acer не определяет метод за заказчика.
Что добавить в техническое задание на дообучение?
Укажите базовую модель, метод, представление весов, длину примеров, число одновременно обрабатываемых примеров и способ сохранения. Добавьте программные зависимости и архитектуру. Для GN100 проверяют Arm/Linux и поддерживаемый стек NVIDIA; для Intel-платформы — свой backend. Переносимость одного этапа не подтверждает весь тренировочный инструмент.
Пилот должен пройти дальше первого шага. Нужны несколько рабочих итераций, наблюдение пика памяти, сохранение состояния и загрузка полученного результата. Если требуется продолжение после остановки, его тоже испытывают. Сохранённый адаптер или модель затем проверяются на отдельном контрольном наборе, чтобы скорость обучения не стала единственным критерием.
Как сравнивать варианты по результату?
Используйте одинаковые данные, метод и критерии качества. Меньший batch или более короткие примеры могут уменьшить память, но меняют условия. Если сравнение меняет сразу несколько параметров, оно уже не показывает только аппаратную разницу. Зафиксируйте допущения и результаты, прежде чем переносить вывод на рабочий проект.
Для регулярного процесса оцените полное время: подготовка данных, обучение, проверка и развёртывание. Отдельно проверьте место под исходные данные и контрольные сохранения. На компьютере, используемом сотрудниками одновременно с обучением, общий бюджет ресурсов отличается от чистого образца. Такой сценарий входит в требования.
В предложении должны быть разделены возможности инференса и дообучения. Максимальное число параметров без метода и условий мало помогает закупке. Для Acer важны воспроизводимая программная среда, доступная память и проверенный цикл именно вашей задачи.
Как выбрать и купить AI-компьютер Асер под локальную модель?
В каталоге AI-станций Veriton Acer и разделе профессиональных компьютеров Acer выбирайте платформу после определения программного стека. Передайте модель, runtime, контекст, число пользователей и критерий приемлемой скорости. Для контейнеров укажите архитектуру образа.
Согласуйте точный объём памяти, SSD, ОС и доступность нужного ПО. Если модель большая, сначала рассчитайте веса и накладные расходы, затем подтвердите пилотом. Не заменяйте испытание обещанием по TOPS или максимальному числу параметров из рекламного описания.
Частые вопросы
Можно ли запускать нейросеть без видеокарты?
Да, если программа поддерживает CPU-вычисления. Скорость зависит от модели, памяти и реализации. Проверьте приемлемую задержку на своём запросе до покупки.
128 ГБ общей памяти равны 128 ГБ VRAM?
Нет. Общий пул используется системой и несколькими вычислительными компонентами. Доступный объём и скорость зависят от архитектуры и ПО; прямое сравнение только по ёмкости неполно.
Поместится ли 70B-модель в 35 ГБ?
35 ГБ — приближение только для четырёхбитных весов 70 млрд параметров. Реальный файл и процесс требуют дополнительной памяти. Учитывайте KV-кэш, runtime и выбранный контекст, затем измеряйте.
Можно ли сложить память двух видеокарт?
Только если программа умеет распределять модель или задачу соответствующим способом. Объёмы не становятся единым пулом автоматически. Проверьте поддержку, связь между GPU и влияние на скорость.
NPU заменяет GPU для любого локального чата?
Нет. Нужны поддерживаемые модель, операции и runtime. Для некоторых задач NPU полезен, для других программа его не использует. Выбирайте по рабочему программному пути.
Какая квантизация лучше?
Она меняет память, скорость и качество. Универсального ответа для всех моделей нет. Сравните результаты на типичных вопросах компании и проверьте ошибки, а не только скорость.
Обязательно ли нужен Linux?
Это зависит от платформы и ПО. Некоторые системы ориентированы на Linux, другие позволяют работать в Windows с поддерживаемым стеком. Архитектуру, драйверы и зависимости уточняют вместе.
Можно ли обучать модель на компьютере для инференса?
Некоторые виды адаптации возможны, но требования отличаются от запуска готовых весов. Полное обучение требует памяти для дополнительных данных и состояний. Сначала определите метод и размер задачи.
SSD ускорит генерацию ответа?
Он влияет на загрузку модели и работу с файлами. При нормальном размещении модели в памяти скорость генерации определяют другие ресурсы. Использование диска из-за нехватки памяти может резко изменить скорость, поэтому запас памяти важен.
Что отправить для подбора конфигурации?
Модель, формат весов, программу, ОС, контекст, число пользователей и измеримый критерий скорости. Для работы по документам добавьте объём базы и правила доступа. Такой набор позволяет подобрать платформу и провести воспроизводимый пилот.